ASFF的TensorFlow2实现
前言
近期想用各种方法提高一下mAP,看了一下ASPP的方法,都说效果不错。感觉可以当一个即插即用的模块。搜了一下代码,都是pytorch,于是就跟着用TensorFlow改写了一下。
主要难点可能就在TensorFlow和Pytorch的部分的函数转换和数据结构的不同。TensorFlow是BHWC,即批数量、高、宽、通道数。Pytorch是BCHW,即批数量、通道数、高、宽。
参考
论文:Learning Spatial Fusion for Single-Shot Object Detection 代码:ASFF
原作代码 level_2 部分有点问题,建议参考以下代码 YOLOX改进之添加ASFF
一点就分享系列(实践篇3—上篇)—修改YOLOV5 魔刀小试+ Trick心得分享(非常推荐研读一下)
结构
ASFF本质上就还是一种金字塔特征融合,不严谨的说有点像全连接,权重还能自适应学习。
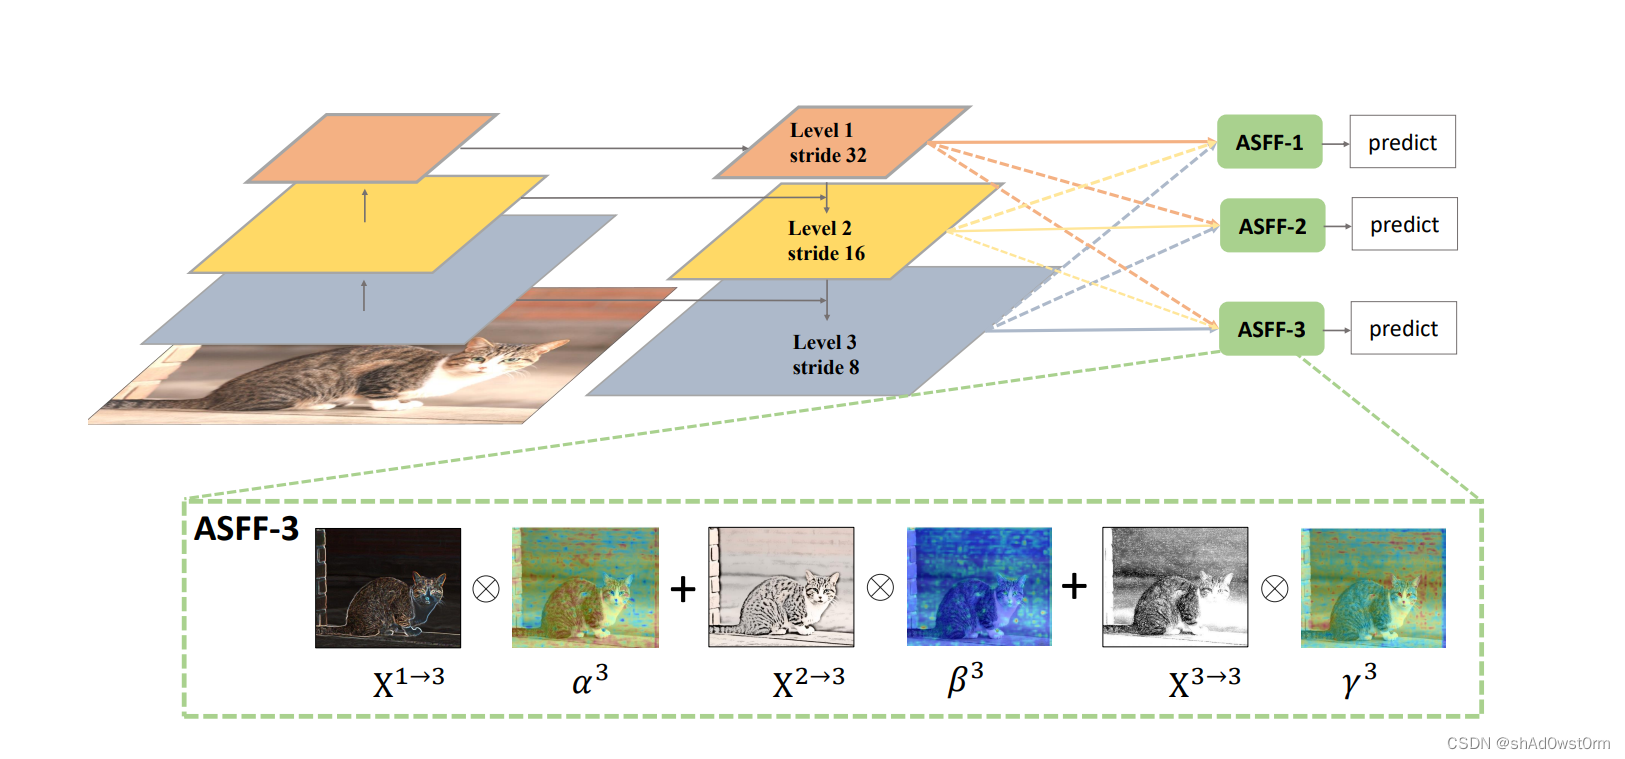
代码
import tensorflow as tf
from tensorflow.keras.layers import Conv2D,BatchNormalization,Activation,LeakyReLU,ReLU
# https://github.com/GOATmessi7/ASFF/blob/4df6f7288b7882a45b8c2dcc3e6e7b499d6cc883/models/network_blocks.py
# https://blog.csdn.net/weixin_45679938/article/details/122354725
#

class add_conv(tf.keras.layers.Layer):
    """
    Add a conv2d / batchnorm / leaky ReLU block.
    Args:
        out_ch (int): number of output channels of the convolution layer.
        ksize (int): kernel size of the convolution layer.
        stride (int): stride of the convolution layer.
    Returns:
        out: Sequential layers composing a convolution block.
    """
    def __init__(self, out_ch,ksize,stride,leaky=True):
        super(add_conv,self).__init__()

        self.conv = Conv2D(filters=out_ch,kernel_size=ksize,strides=stride,padding='same',use_bias=False)
        self.bn = BatchNormalization()
        self.act = LeakyReLU(0.1) if leaky==True else ReLU(6.0)

    def call(self,x):
        return self.act(self.bn(self.conv(x)))

class ASFF(tf.keras.layers.Layer):
    def __init__(self,
                 level,
                 rfb=False,
                 # vis=False
                 ):
        super(ASFF,self).__init__()
        self.level = level
        self.dim = [512,256,128]
        self.inter_dim = self.dim[self.level]
        rfb
        if level == 0:
            self.stride_level_1 = add_conv(self.inter_dim,3,2) # in_channel = 512
            self.stride_level_2 = add_conv(self.inter_dim,3,2) # in_channel = 512
            self.expand = add_conv(512,3,1) # 输出是要给head的特征
        elif level==1:
            self.compress_level_0 = add_conv(self.inter_dim, 1, 1) # in_channel = 256
            self.stride_level_2 = add_conv(self.inter_dim, 3, 2) # in_channel = 256
            self.expand = add_conv(256, 3, 1) # 输出是要给head的特征
        elif level==2:
            self.compress_level_0 = add_conv(self.inter_dim, 1, 1) # in_channel = 128
            self.compress_level_1 = add_conv(self.inter_dim, 1, 1) # in_channel = 128
            self.expand = add_conv(128, 3, 1) # 输出是要给head的特征

        compress_c = 8 if rfb else 16  #when adding rfb, we use half number of channels to save memory

        self.weight_level_0 = add_conv(compress_c, 1, 1)
        self.weight_level_1 = add_conv(compress_c, 1, 1)
        self.weight_level_2 = add_conv(compress_c, 1, 1)

        self.weight_levels = Conv2D(3,kernel_size=1,strides=(1,1),padding='valid')
        # self.vis = vis

    def call(self, x_level_0, x_level_1, x_level_2):
        if self.level == 0:
            level_0_resized = x_level_0
            level_1_resized = self.stride_level_1(x_level_1)

            level_2_downsampled_inter =tf.nn.max_pool2d(x_level_2, 3, strides=2, padding="SAME")   # 源代码padding = 1怀疑就是same,毕竟ksize=3,3//2=1
            level_2_resized = self.stride_level_2(level_2_downsampled_inter)

        elif self.level==1:
            level_0_compressed = self.compress_level_0(x_level_0)
            # level_0_resized =F.interpolate(level_0_compressed, scale_factor=2, mode='nearest')
            # https://blog.csdn.net/weixin_40128276/article/details/104958708
            _,H,W,_ = level_0_compressed.shape
            level_0_resized = tf.image.resize(level_0_compressed,[H*2,W*2],method=tf.image.ResizeMethod.NEAREST_NEIGHBOR)

            level_1_resized = x_level_1
            level_2_resized = self.stride_level_2(x_level_2)

        elif self.level==2:
            level_0_compressed = self.compress_level_0(x_level_0)
            _,H,W,_ = level_0_compressed.shape
            level_0_resized = tf.image.resize(level_0_compressed,[H*4,W*4],method=tf.image.ResizeMethod.NEAREST_NEIGHBOR)

            x_level_1_compressed = self.compress_level_1(x_level_1)

            _,H,W,_ = x_level_1.shape
            level_1_resized = tf.image.resize(x_level_1_compressed,[H*2,W*2],method=tf.image.ResizeMethod.NEAREST_NEIGHBOR)
            level_2_resized = x_level_2

        level_0_weight_v = self.weight_level_0(level_0_resized)
        level_1_weight_v = self.weight_level_1(level_1_resized)
        level_2_weight_v = self.weight_level_2(level_2_resized)
        # levels_weight_v = torch.cat((level_0_weight_v, level_1_weight_v, level_2_weight_v),1) # torch BCHW concat in channel
        levels_weight_v = tf.concat((level_0_weight_v, level_1_weight_v, level_2_weight_v),3) # tensorflow BHWC
        # levels_weight = F.softmax(levels_weight, dim=1)
        levels_weight = self.weight_levels(levels_weight_v)
        levels_weight = tf.nn.softmax(levels_weight,axis=-1)

        # pytorch
        # fused_out_reduced = level_0_resized * levels_weight[:,0:1,:,:]+\
        #                     level_1_resized * levels_weight[:,1:2,:,:]+\
        #                     level_2_resized * levels_weight[:,2:,:,:]

        fused_out_reduced = level_0_resized * levels_weight[:,:,:,0:1]+\
                            level_1_resized * levels_weight[:,:,:,1:2]+\
                            level_2_resized * levels_weight[:,:,:,2:]

        out = self.expand(fused_out_reduced)

        # if self.vis:
        #     return out,levels_weight,fused_out_reduced.sum()
        # else:
        #     return out
        return out

if __name__ == "__main__":

    P5 = tf.keras.Input(shape=(13,13,512),batch_size=1)
    P4 = tf.keras.Input(shape=(26,26,256),batch_size=1)
    P3 = tf.keras.Input(shape=(52,52,128),batch_size=1)

    P5_ASFF =ASFF(level=0)(P5,P4,P3)
    P4_ASFF =ASFF(level=1)(P5,P4,P3)
    P3_ASFF =ASFF(level=2)(P5,P4,P3)

    print(P5_ASFF,P4_ASFF,P3_ASFF)